SEO
GCS MCP 主要优势是分析问题
昨天提了下 GCS MCP 这个开源项目,那继续就着这个话题补充一下这个 MCP 的主要用途。 其实看基础自然搜索指标,随便打开网页便可以看到,那单纯使用这款 MCP 去看网站数据就有点大材小用。 像

昨天提了下 GCS MCP 这个开源项目,那继续就着这个话题补充一下这个 MCP 的主要用途。 其实看基础自然搜索指标,随便打开网页便可以看到,那单纯使用这款 MCP 去看网站数据就有点大材小用。 像
分享几个我平时工作过程中用得比较多的 MCP 工具,涉及数据调研、内容抓取、网站更新,以及后续的数据分析。 数据调研这块,之前用过一段时间的 DataForSEO MCP,主要处理关键词研究,看搜索结
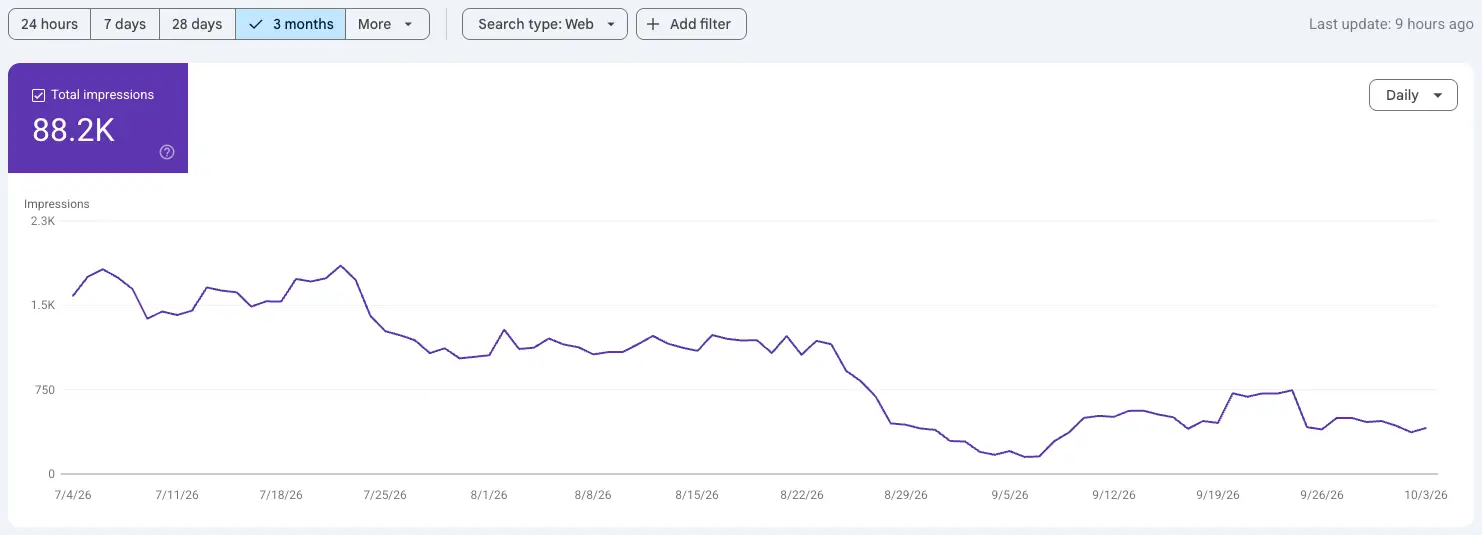
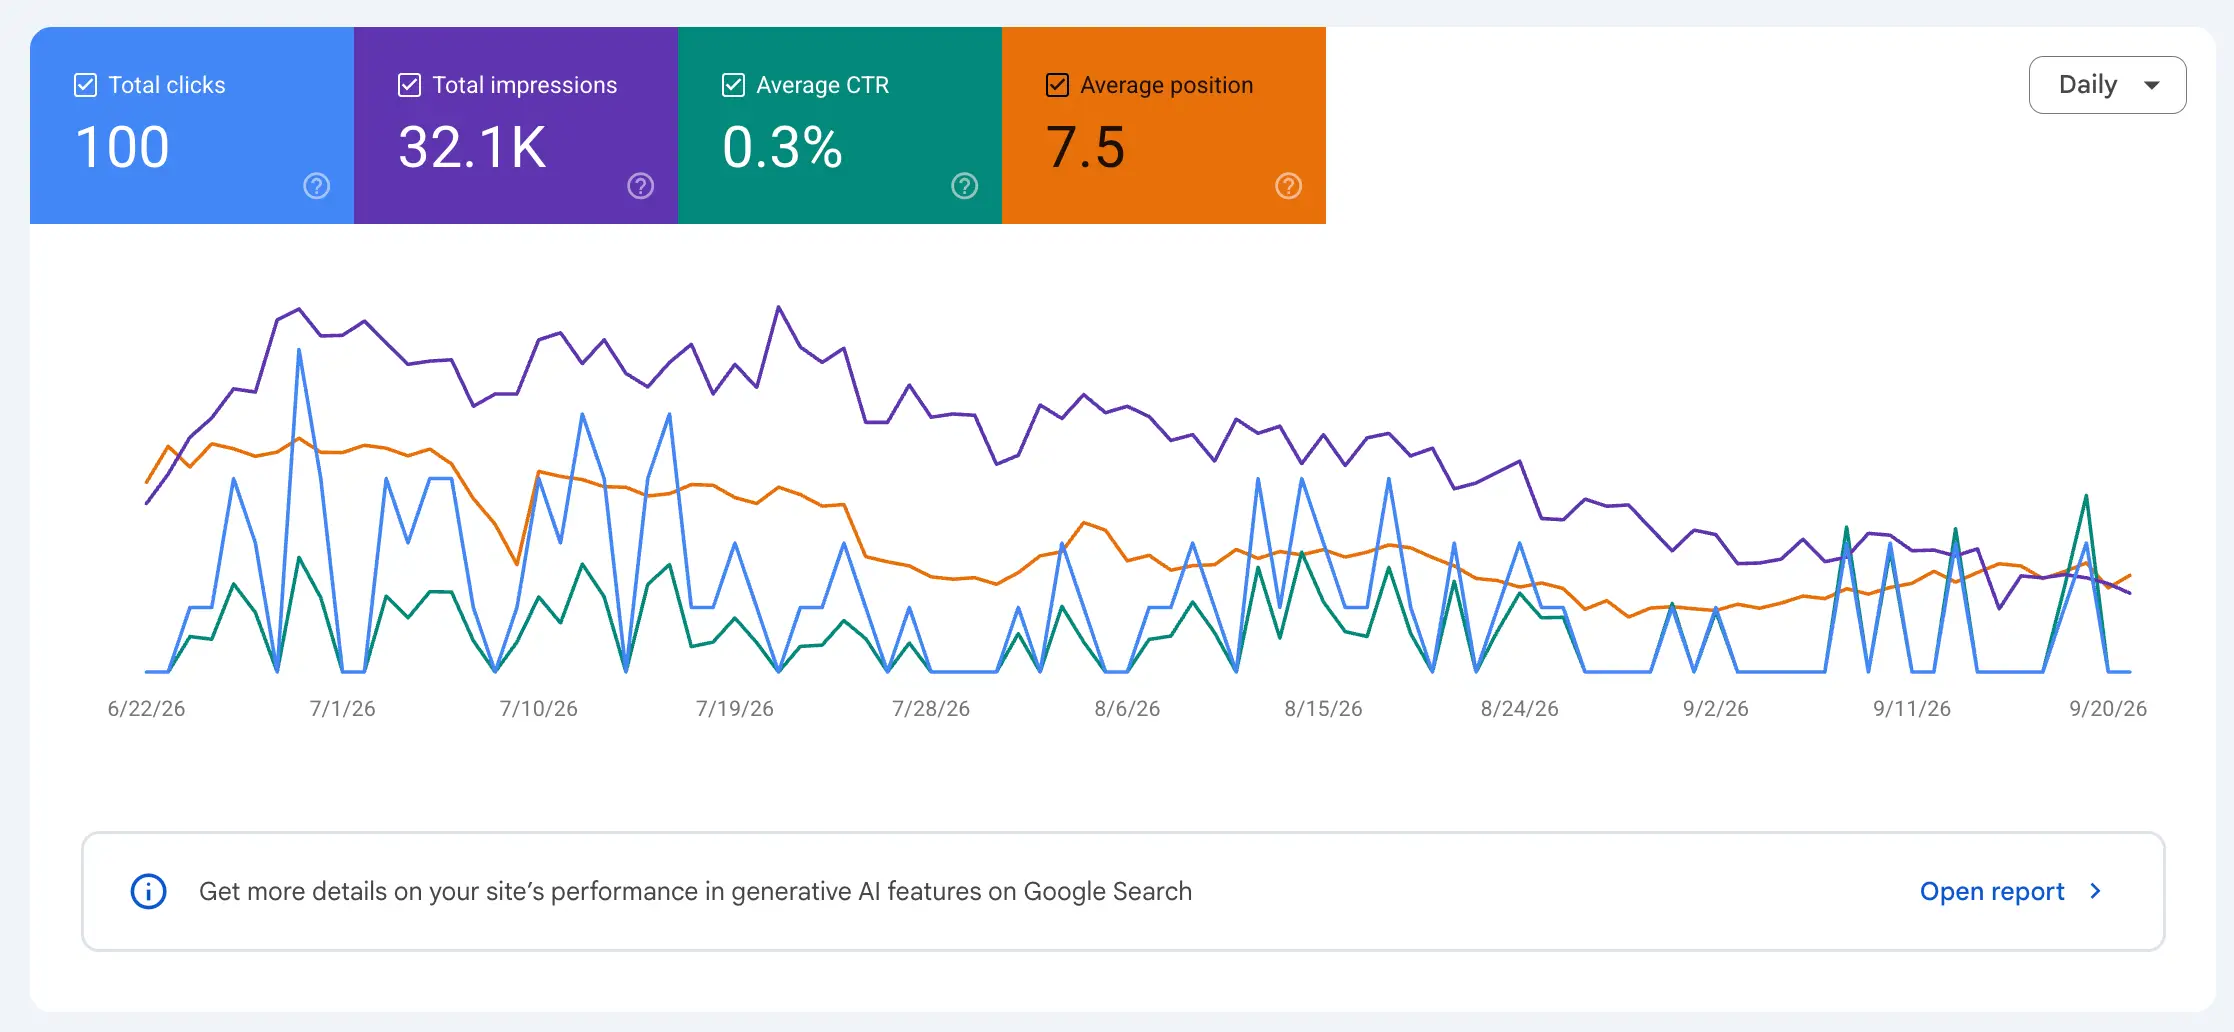
传统 SEO 主要是跟踪关键词排名,但在 AI 搜索的当下,我们的网站品牌在 AI 搜索回答里并没有稳定的“第几名”概念。 更多的是我们的品牌被 AI 模型提及了多少次,或者引用了多少次。 目前谷歌站
谷歌搜索中心官方博客在 1 号更新了关于网站使用生成式 AI 内容的官方指南,下午我自己看了一遍,觉得这可以展开聊聊这件事。 这篇官方指南所传达的信息很重要,第一次以非常强烈的措辞要求网站发布者在内容
这周因为假期的缘故,基本都没怎么工作,每天的主要任务就是研究吃点什么。 也没出去玩,到处都是人基本没什么体验感,索性后面找段专门的时间出去体验一下。 其实这种“半退休”的生活方式我还是挺喜欢的,没什么
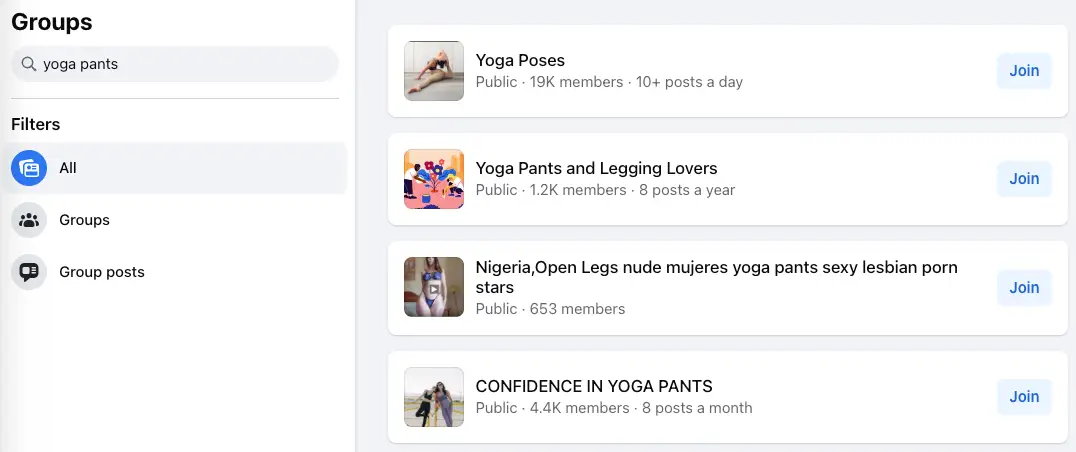
找到用户在网上的痕迹,并通过这些痕迹去分析用户的需求,我觉得非常有必要。 如果我做的是 C 端独立站,一般我会去几个主流的电商平台上,调研用户在商品信息详情下的评价信息。 这种方法其实没有什么捷径可走
今天翻邮件消息,看到我之前经常用的一家邮件订阅服务商 MailerLite 开放了 MCP 功能,觉得可以就着将 AI 能力融入邮件营销这个点展开聊聊。 MCP 理解起来挺简单的,就是一个让 AI 与
节日快乐。 这几天没怎么上班,随意分享一下我自己的网站版本管理的经验。 之前我喜欢把网站的基线版本做得大且全,这样就方便所有项目的快速上线,毕竟只需要去修改一些基础信息便可以快速把网站内容做好。 但这
从八月份开始 Google Discover 信息流开始有了两个明显的变化,一是视频相关的内容越来越多,二是广告出现的次数也越来越多。 像下面这张图片便是我刚刚截取的信息流上的一部分内容,可以非常明显
现在 CodeX 这样的工具越来越方便了,如果你想做 On-Page SEO 相关细节审核,仅仅只需要一条命令便可以很顺利地将整个流程进行下去。 AI 会自动打开浏览器,然后打开具体的网页,读取里面的
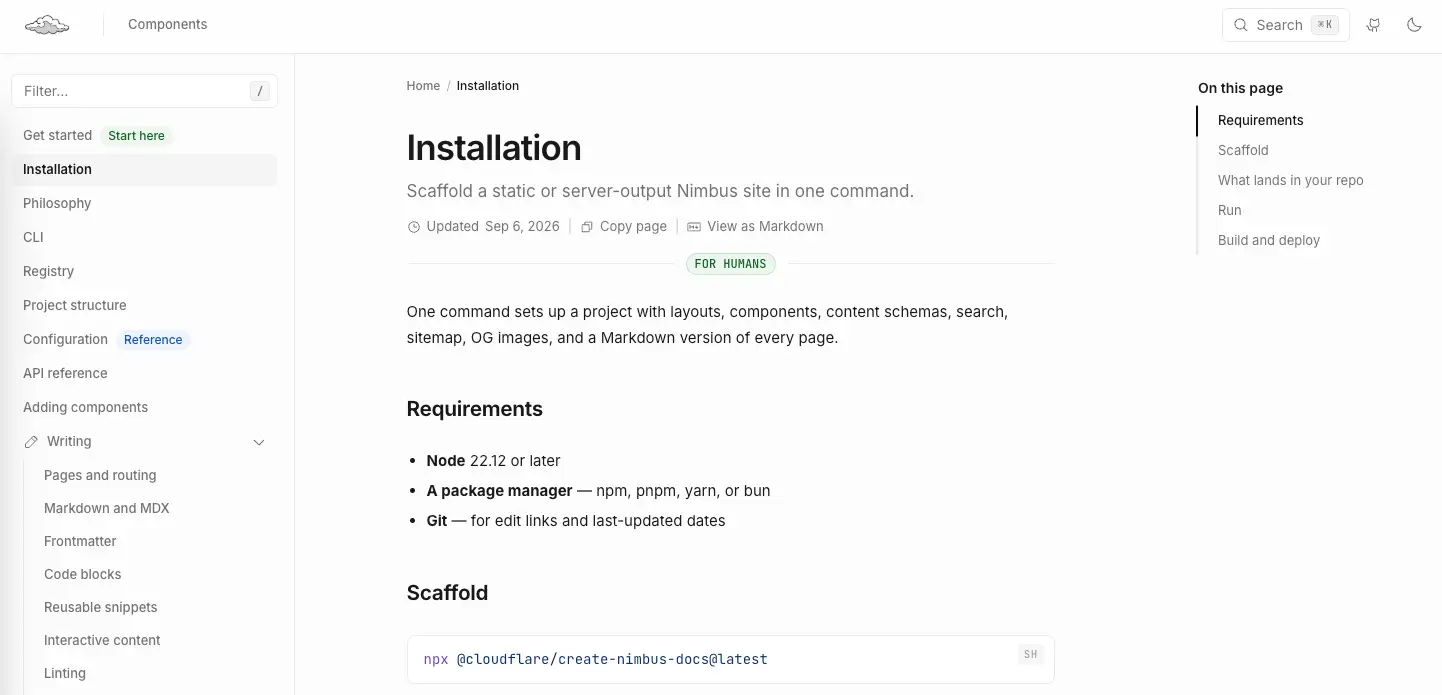
简单分享一下 Cloudflare 最近发布的这个叫做 Nimbus 的开源文档框架。 之所以想分享这个内容,主要原因有两点。 一是这个文档框架特别适合用来做内容类型站点,类似上图这样的布局,左侧大分
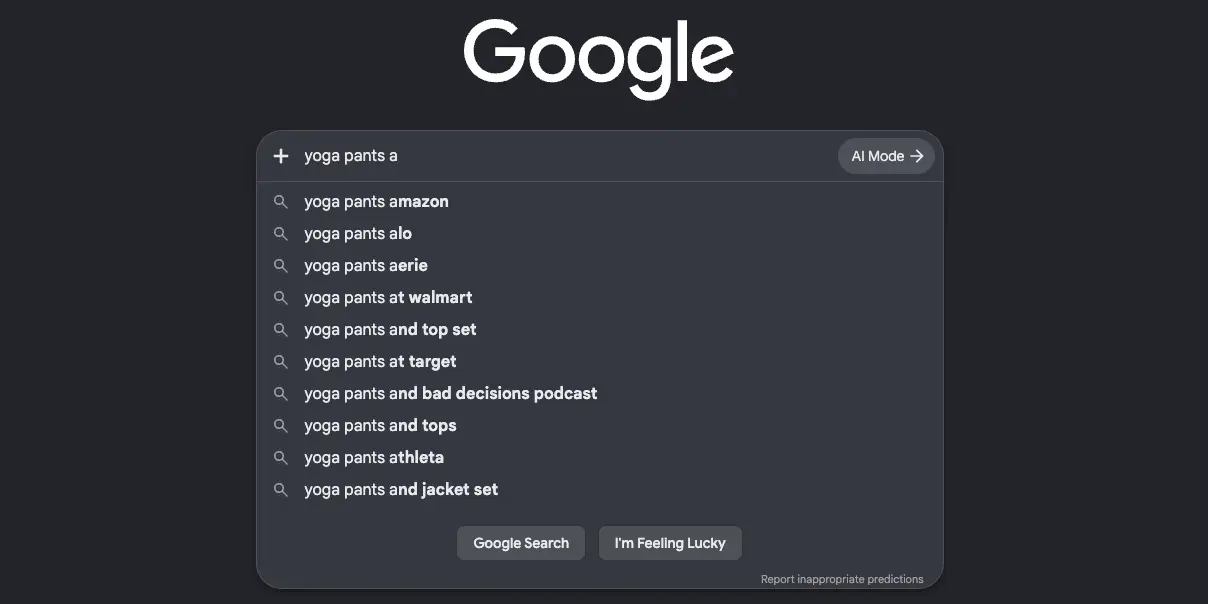
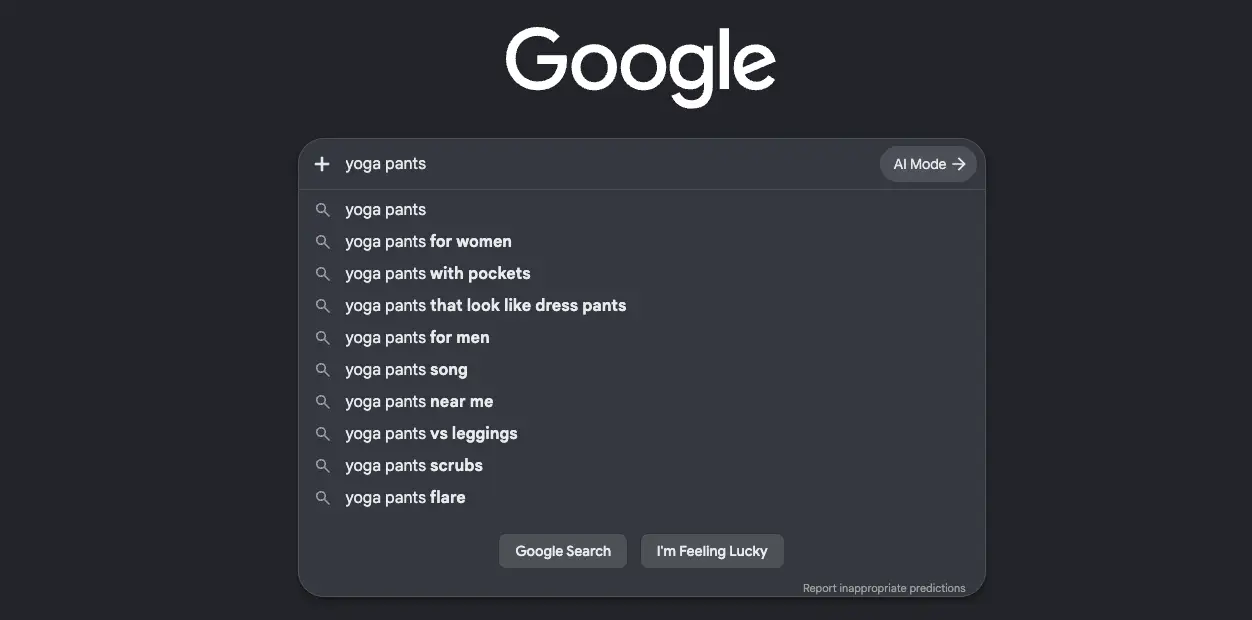
这周在工作流程的梳理上花了不少时间,主要原因就是有了新的思路,就觉得之前写的那些逻辑没那么有用了。 举个最简单的例子,谷歌搜索下拉框的关键字建议,之前我的处理逻辑是先把信息抓取下来并清洗好,再使用 A
之前有篇文章分享了 Jev 这款模型在 SEO 领域内的一些应用场景,写完那篇文章之后便开始着手开发了一款关键词属性判断脚本。 应用场景非常简单,就是对一大堆关键词进行属性判断,并进行相应的主题聚类。
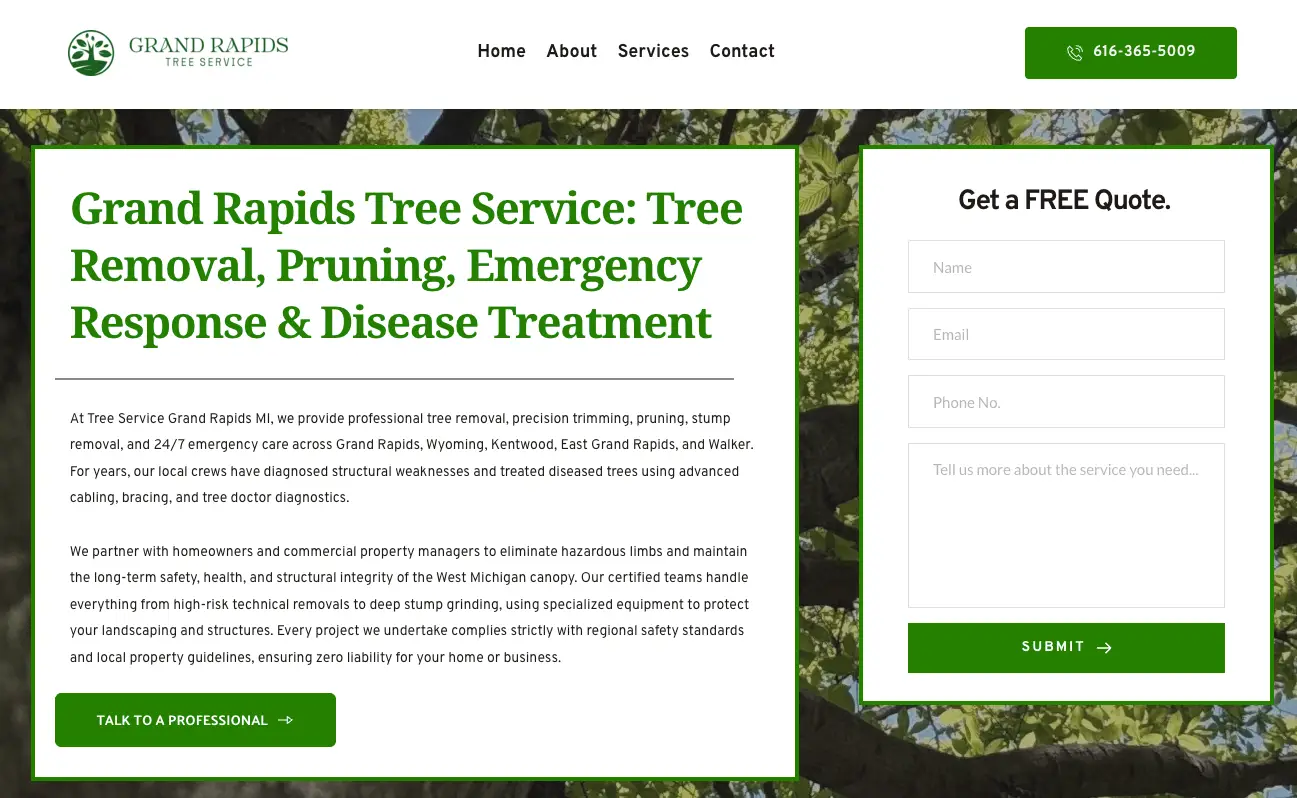
分享一个这两天看到的 Local SEO 案例。 逻辑比较简单:搭建一个本地服务类型的网站,并做好本地 SEO 相关的设置来获取精准的本地搜索流量。 至于这类本地流量的变现,如果你有后端交付能力的话可
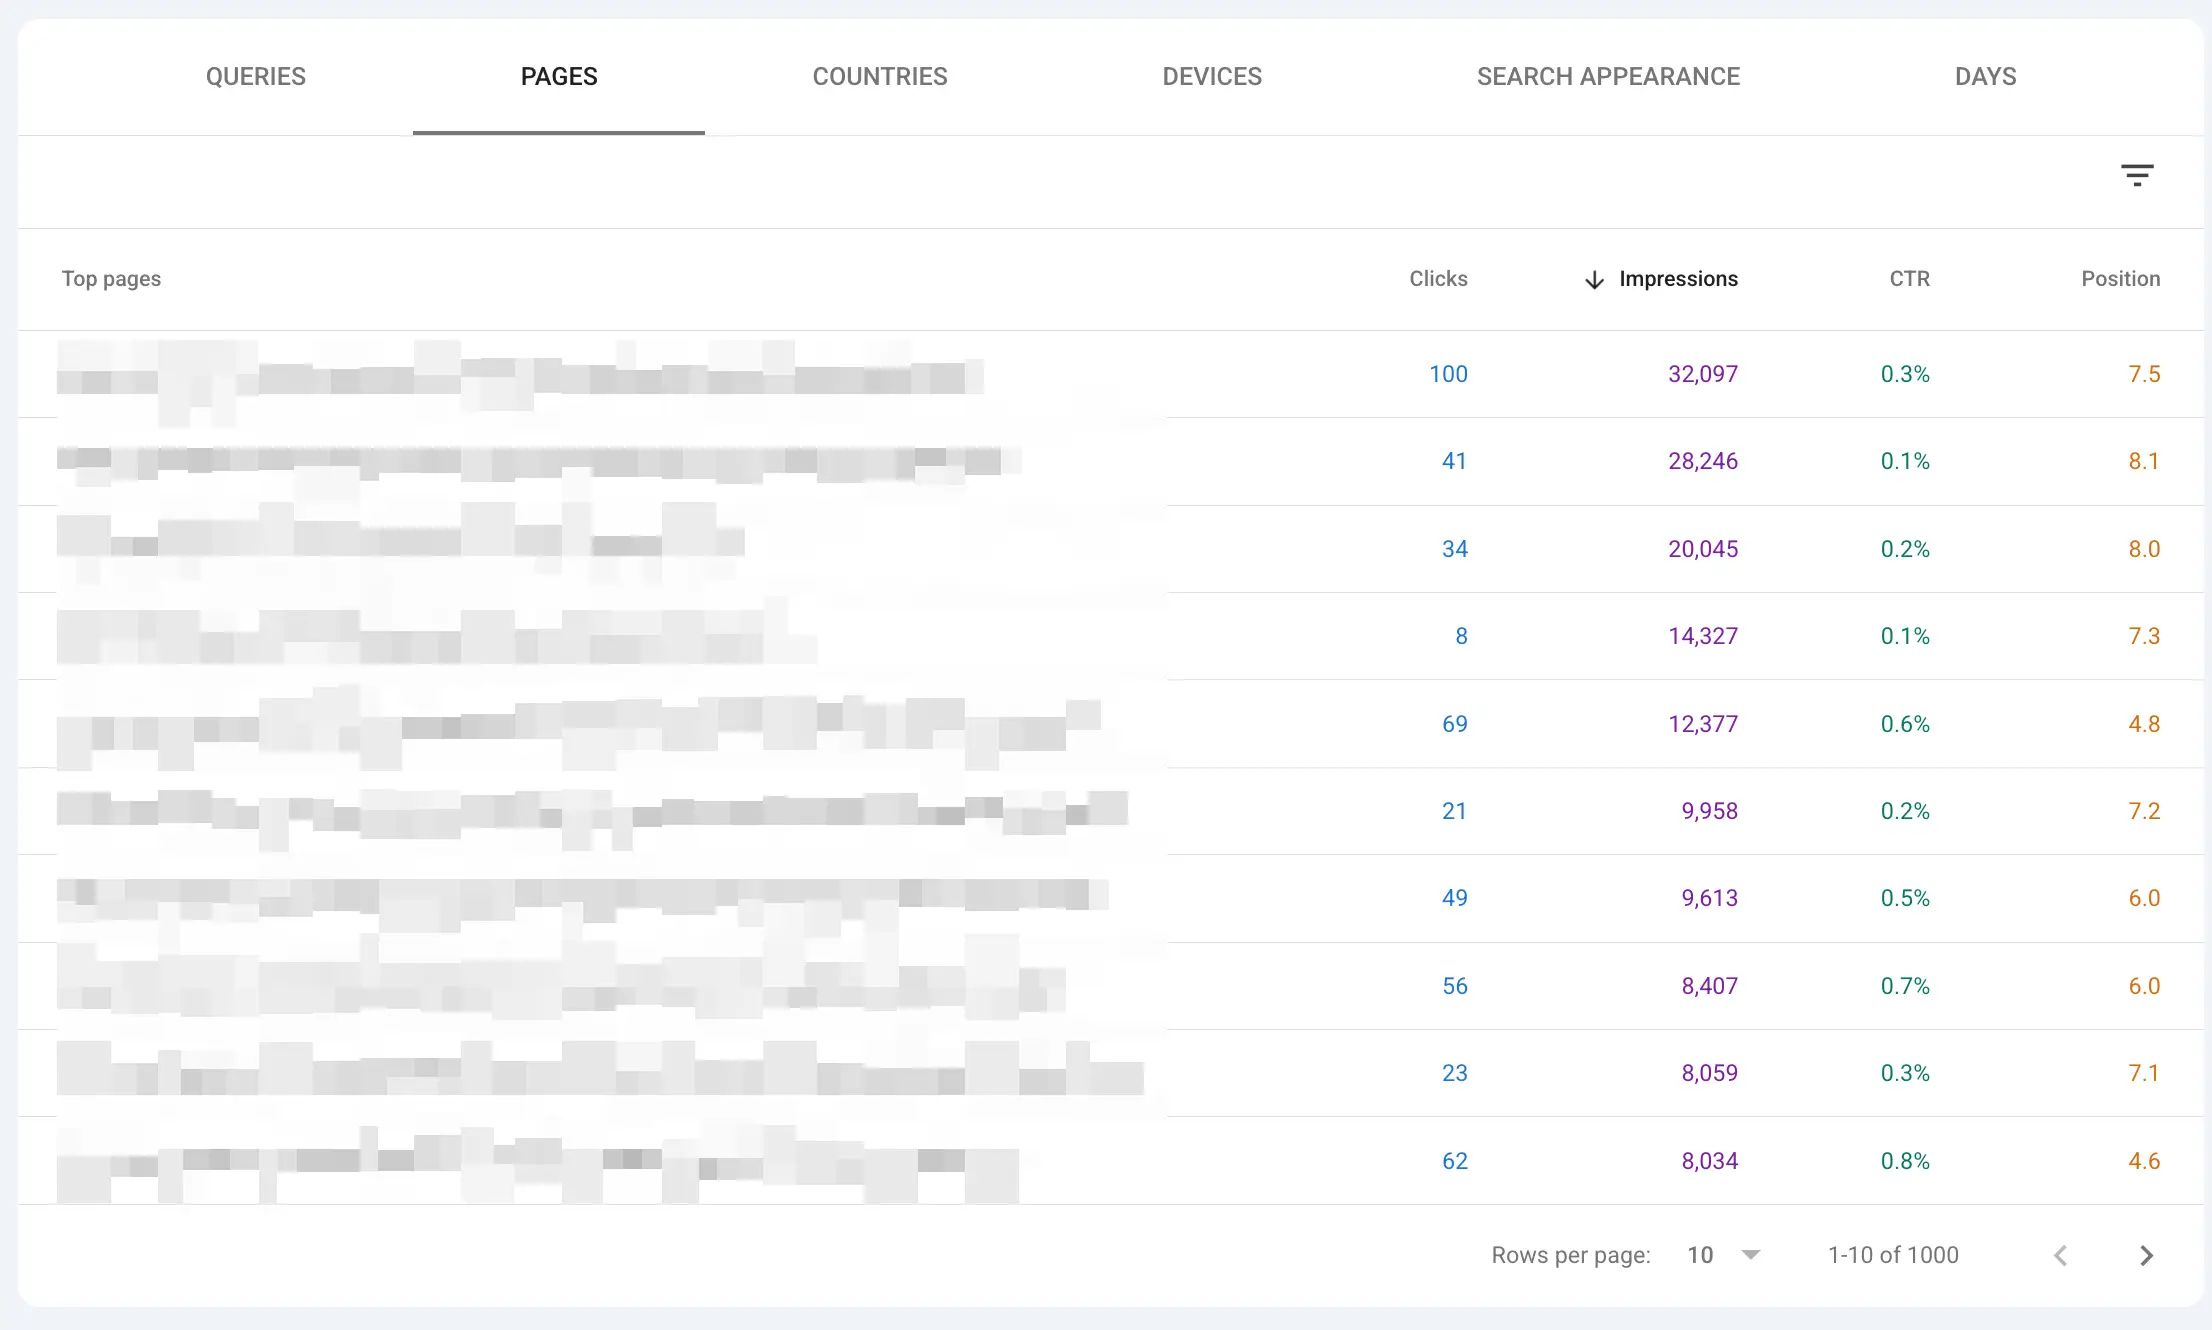
相较于优化网站上的已有内容,我平时更喜欢写新内容,单纯就是因为优化已有内容非常消耗心力。 你先得通读一下这篇已有内容主要写的什么,再去做数据统计并做想好相应的 GAP 分析,然后还需要设计内容更新计划
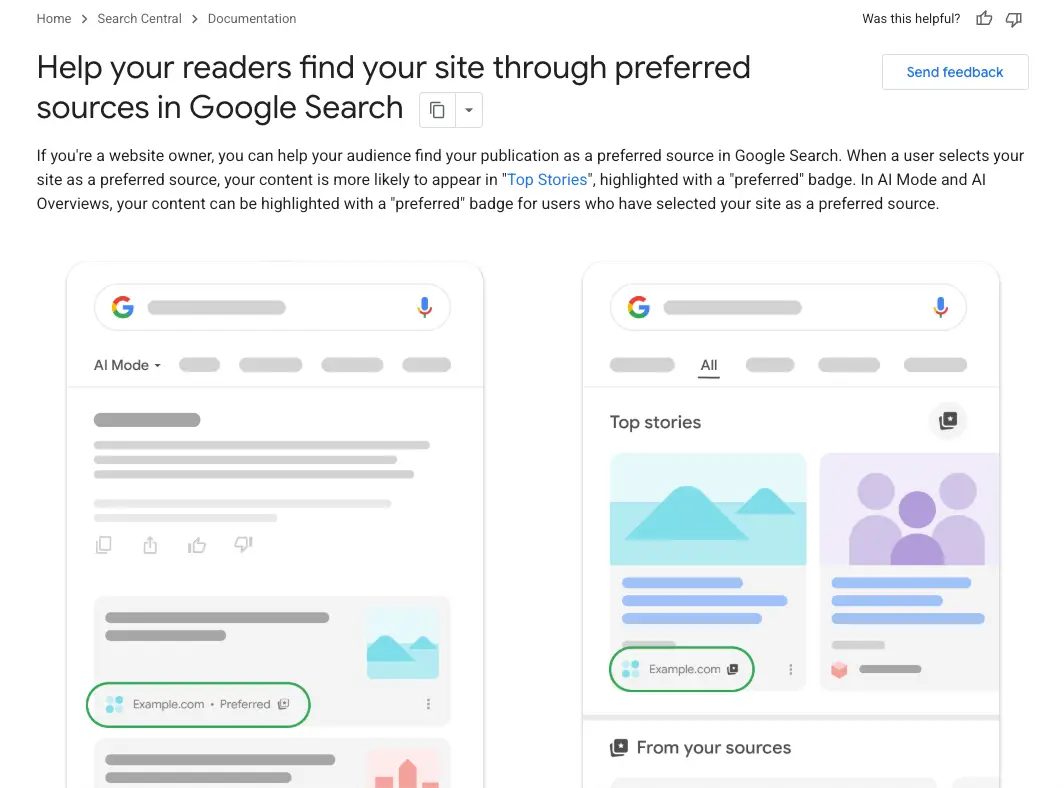
前两天谷歌更新了 Preferred Sources 文档,其中有一个比较重要的点,就是现在站长可以直接在网站、邮件和社媒中引导用户把自己的域名设为“首选来源”。 当你的网站被用户选中并标记后,那后续
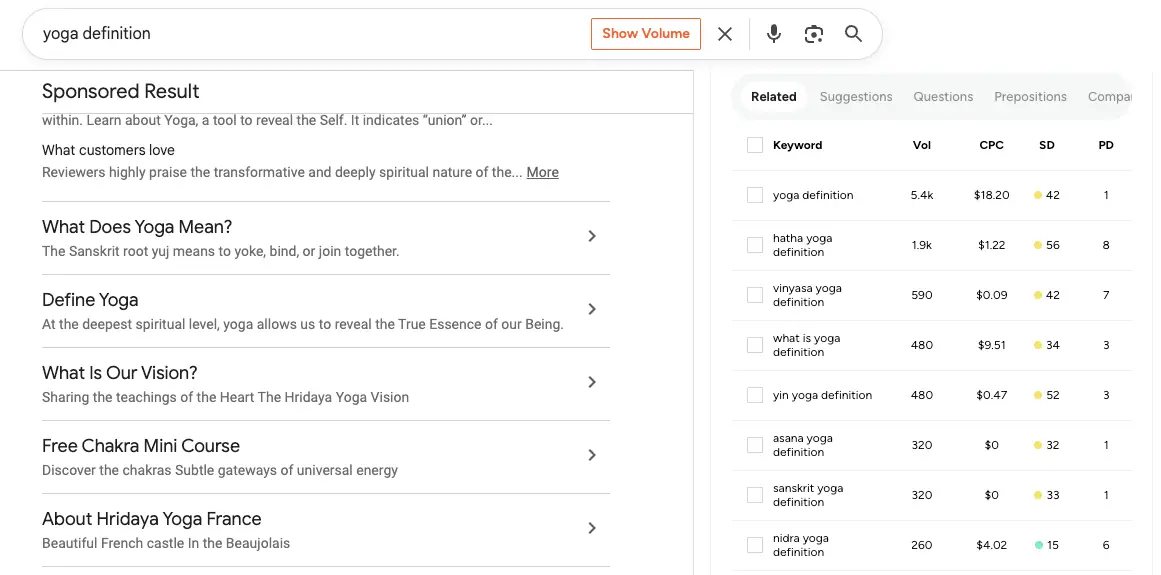
在关键词的调研上 AI 模型的能力已经很强了,即便这样,我还是喜欢在调研阶段更多靠自己动手挖掘信息。 等基础大方向确定之后,再来借助 AI 模型的能力进行数据放大。 比如最基础的一种模式,反查竞争对手
这两天社交媒体里全在刷屏 Jev 模型,趁着周末特意恶补了一下它的基础知识。 这款模型与传统生成式大模型最大的不同在于:Jev 完完全全不生成任何文本,它只专注于提供毫秒级、超低成本的结构化决策。 比
这周就做了三件事,处理完上周没做完的网站数据统计,调整 WooCommerce 产品上架流程,还有就是将网站内链优化流程设计出来了。 第一件事其实上周有分享过,只是网站数据量比较多当时没有做完,所以陆
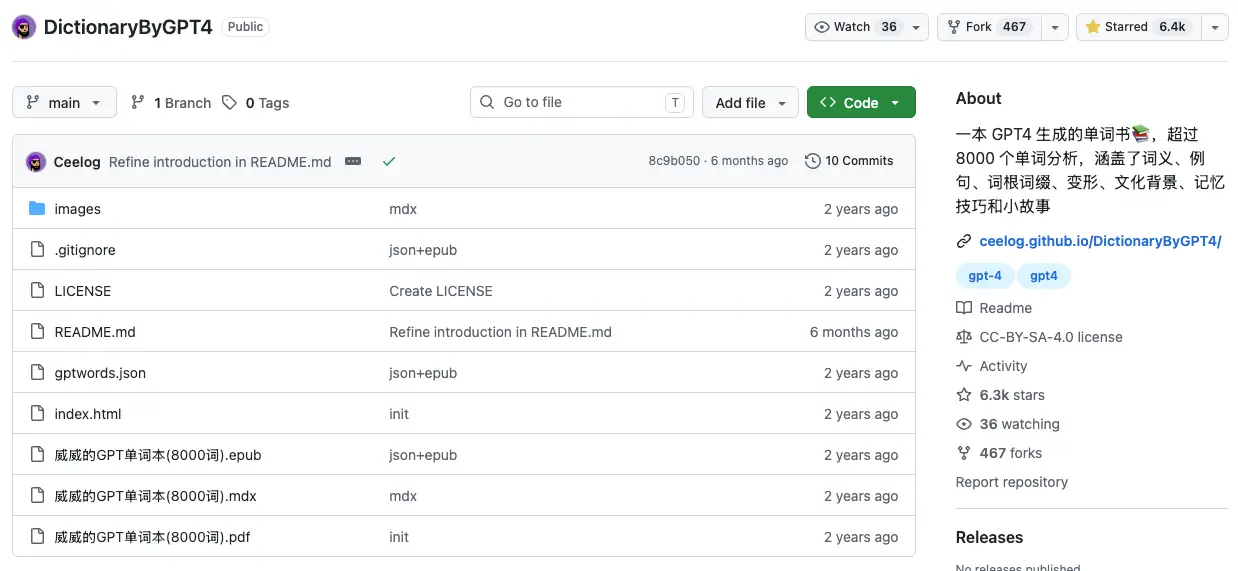
之前的文章分享中有谈过,我最近在实验着用 AI 做内部链接优化。 但目前市面上这些开源的 skill 都存在着一些比较大的弊端。 比如最简单的一个场景,你下载一个 skill 并让这个 skill 扫
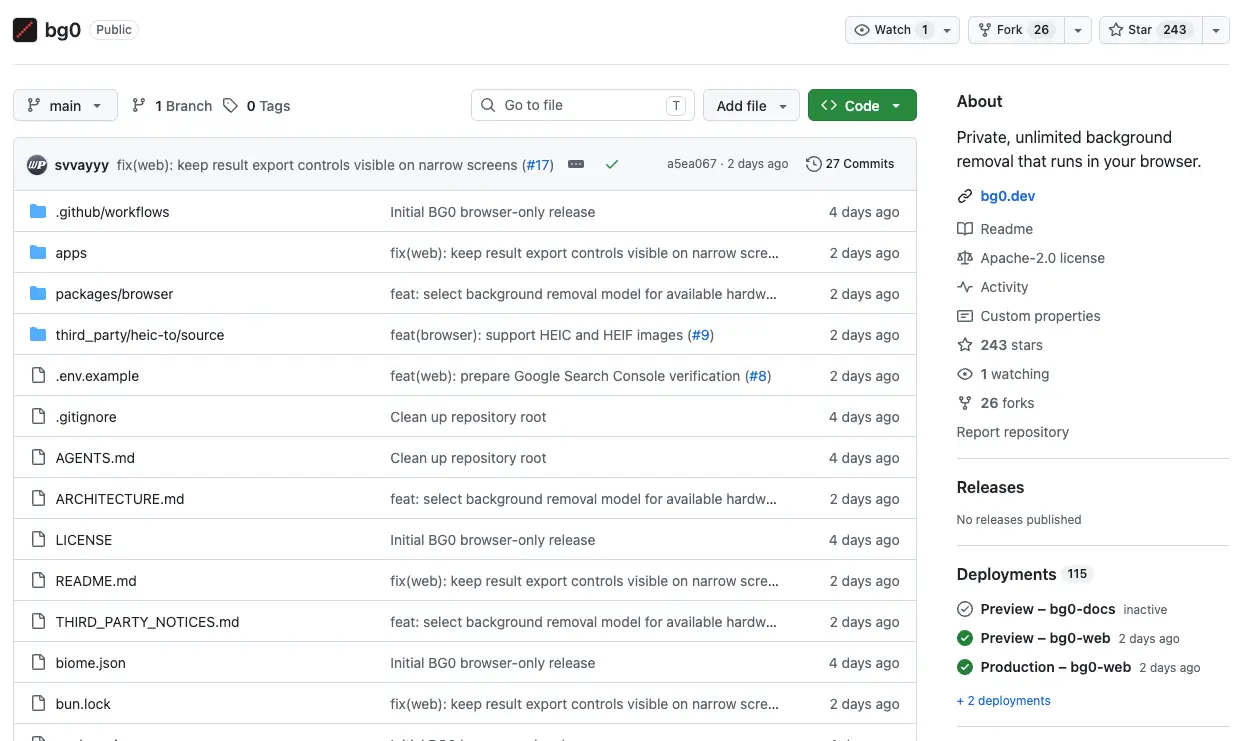
抠图在我的工作中应用得比较频繁,尤其是在处理商品详情页面中的场景信息时。 我通常会先从原图中把商品主体抠出来,利用 AI 生成一批新的使用场景,再选一张应用到商品详情页面中去。 过去这种抠图服务,我使

下午在星球看到一个帖子,大意是说现在有了 AI 的帮助,上线一个网站并不是什么难事了,难的是流量获取以及后续的持续运营。 其实看到这种问题,我还挺感同身受的,所以利用这篇文章单独输出一下我自己的看法。
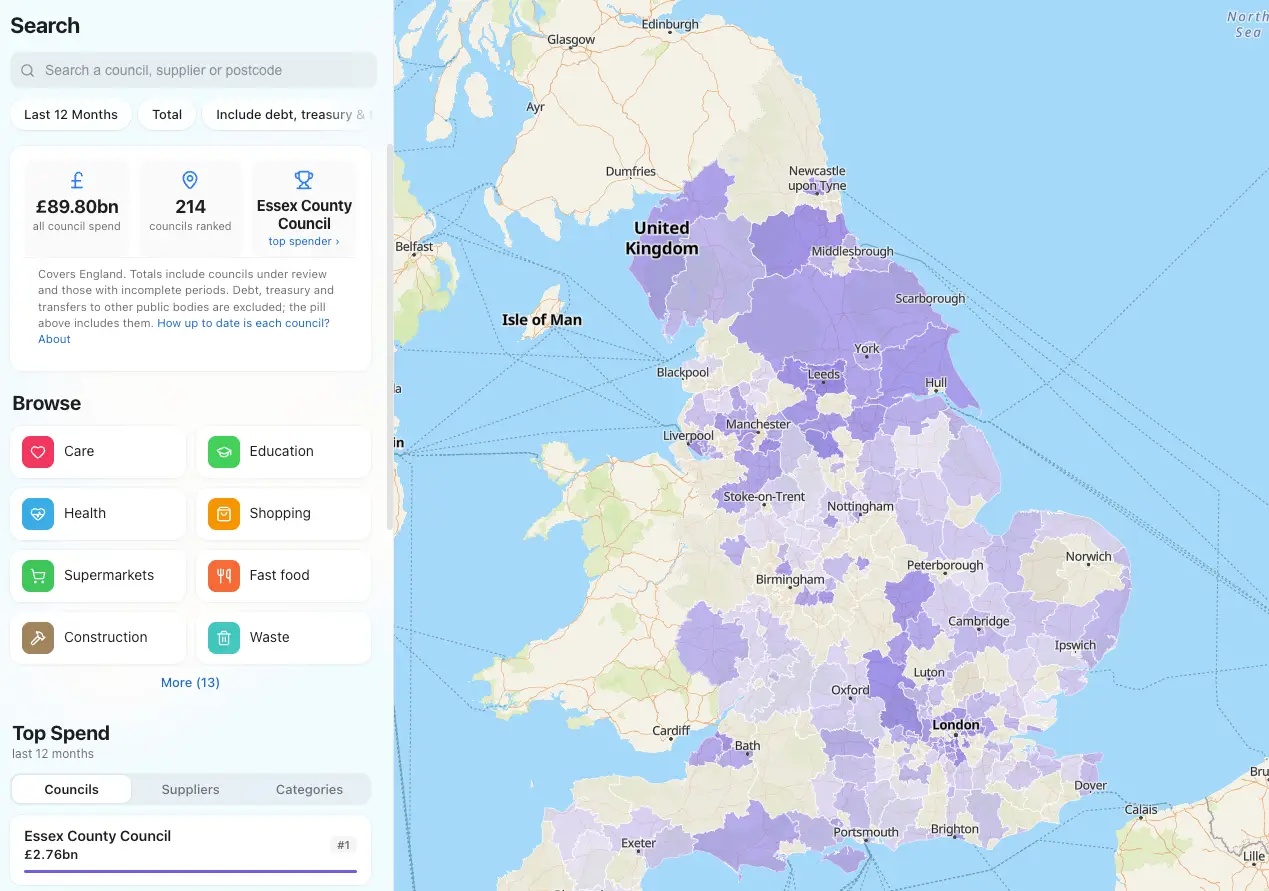
过去做程序化 SEO 站点时,一般的逻辑都是去找数据,然后对数据进行清洗并分组整理。 等数据梳理得差不多之后,便可以基于数据逻辑和业务逻辑将其在页面上展示出来。 有些时候数据集会非常庞大,自然会导致最
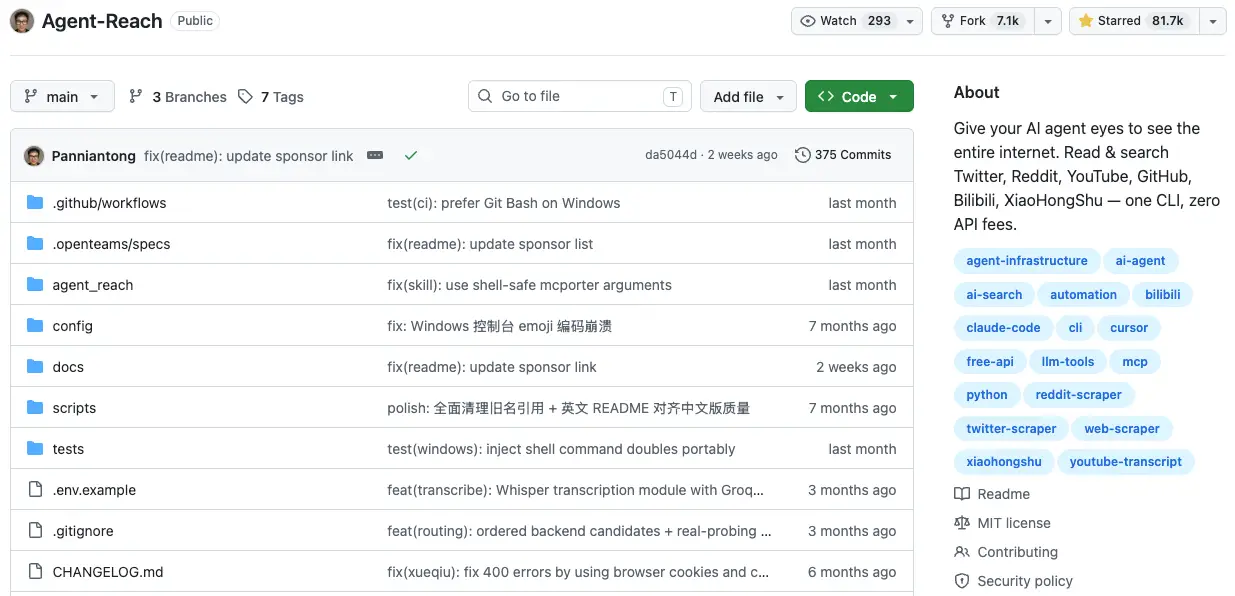
今天体验了一下 Agent-Reach 这个项目,整体表现挺不错的。 其实它解决的是一个看似比较简单、但实际处理起来比较棘手的问题:如何让 AI Agent 真正具备稳定且实用的线上信息获取能力。 我