
搜索引擎怎么处理 PDF 文档
上午在调研一个关键词时,发现首页上有一条 PDF 文档结果,所以我当时就比较好奇搜索引擎算法是怎么处理这种 PDF 文档的。 毕竟相较于传统的 HTML 页面信息,PDF 文档上的信息并不是那么容易能 […]
上午在调研一个关键词时,发现首页上有一条 PDF 文档结果,所以我当时就比较好奇搜索引擎算法是怎么处理这种 PDF 文档的。 毕竟相较于传统的 HTML 页面信息,PDF 文档上的信息并不是那么容易能 […]
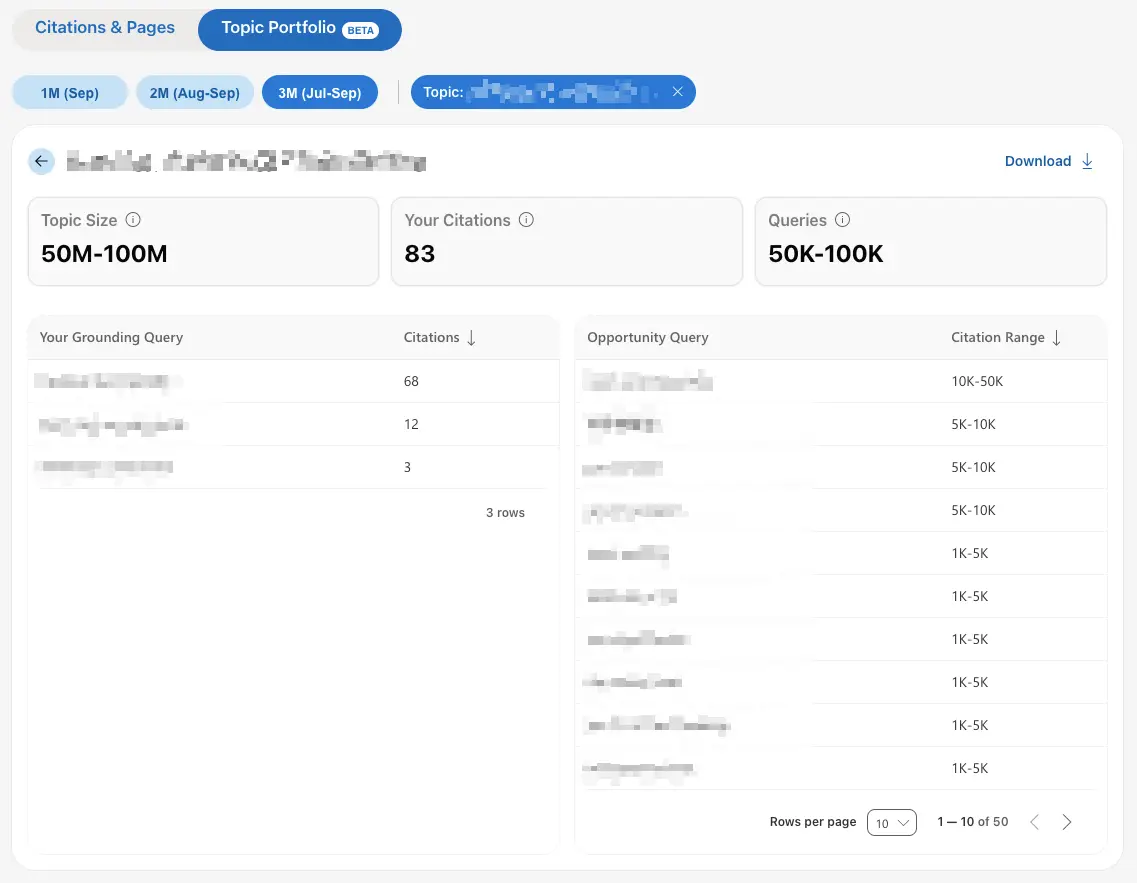
必应站长工具最近推出了一个名为 Topics Portfolio 的测试版功能,目的就是试图帮助我们了解必应搜索的 AI 回答里,一般会在哪些主题中引用我们的网站内容,以及同一主题下有哪些搜索问题引用
做商品详情页面,我现在总的原则是精细化、精品化的模式在做,算是彻底放弃了前几年喜欢用的采集玩法。 之所以这么做,一是因为这种商品页面的采集玩法已经很难从搜索引擎获得流量了,二是因为管理几万条 SKU
我现在做信息调研,无论是关键词搜索结果页面的调研,还是竞争对手网站的调研,还是更喜欢人工手动去做。 究其原因,主要是因为人工手动做这件事时,能发现更多细节信息,并能通过这些细节信息进行思维拓展。 还是
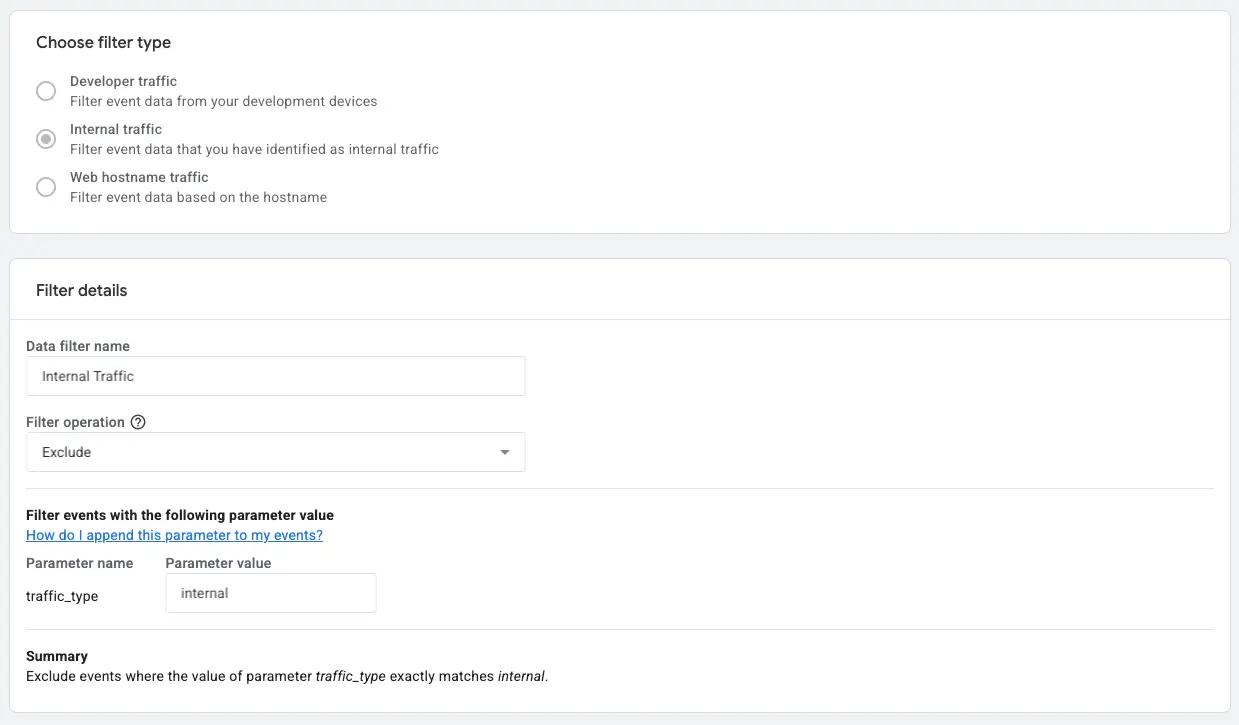
内部流量的配置方法不难,直接定位自己常用的 IP 地址或者 IP 地址段,然后再将其配置到 GA 这类访客行为统计工具中去。 激活配置规则后,后续从这些 IP 地址中来的访客便不会被记录到相应的数据报
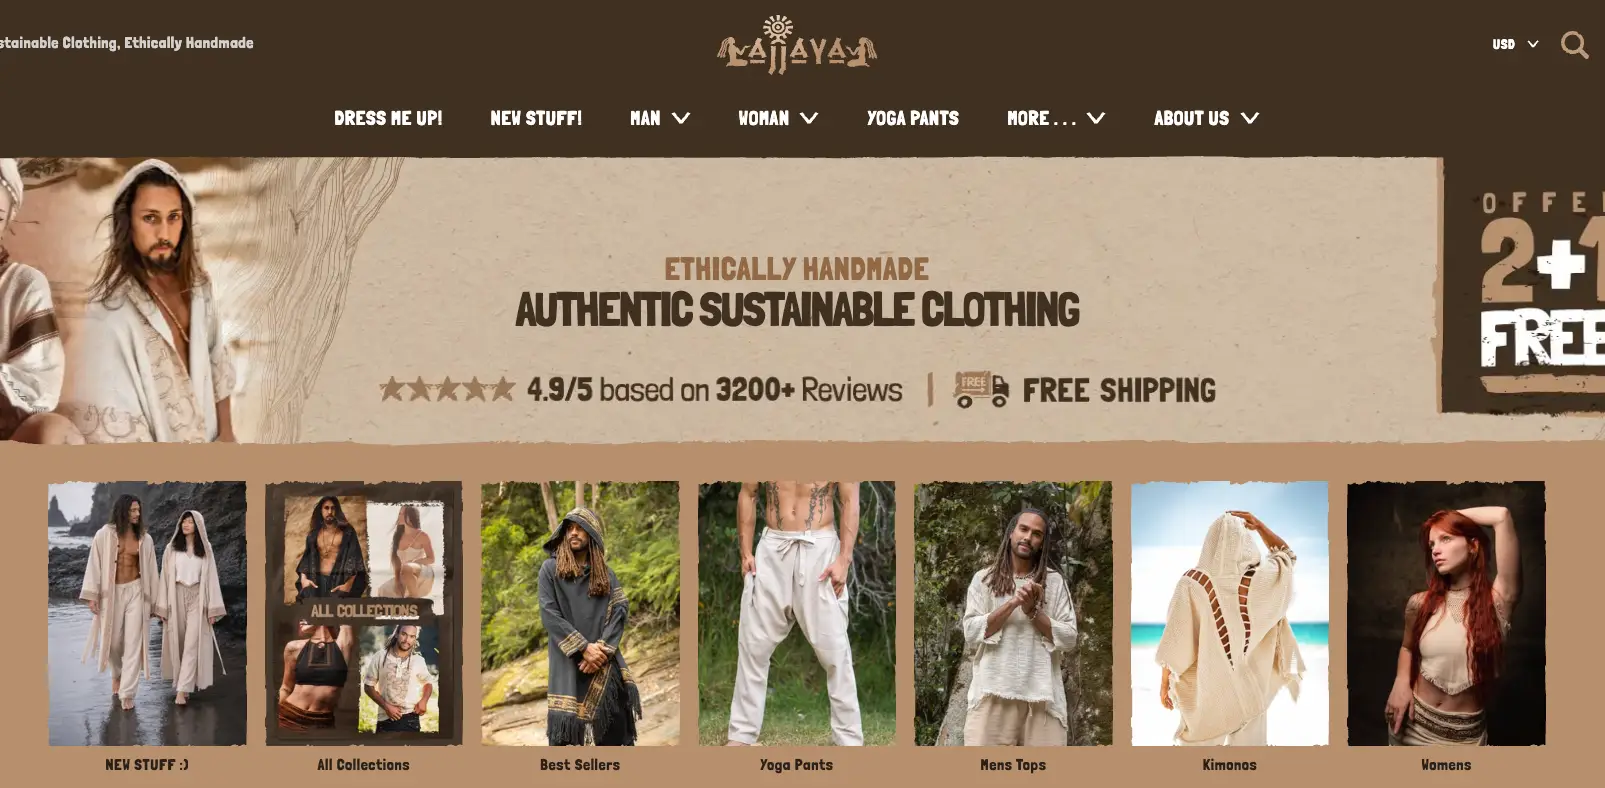
上午在调研的过程中发现一个看起来特别简单的网站,觉得他的操作逻辑值得学习。 表面上看,这个网站做得非常简单。 比如上面便是产品分类页,配合简单的背景图片与对应的细分产品关键词,一个产品大类的类目页面便
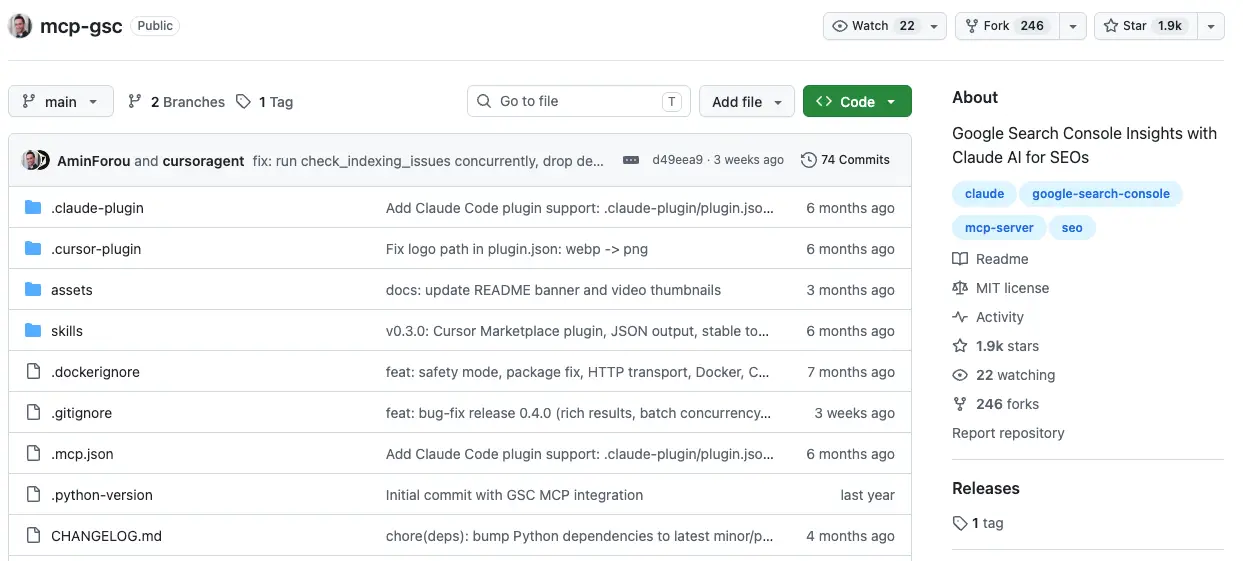
昨天提了下 GCS MCP 这个开源项目,那继续就着这个话题补充一下这个 MCP 的主要用途。 其实看基础自然搜索指标,随便打开网页便可以看到,那单纯使用这款 MCP 去看网站数据就有点大材小用。 像
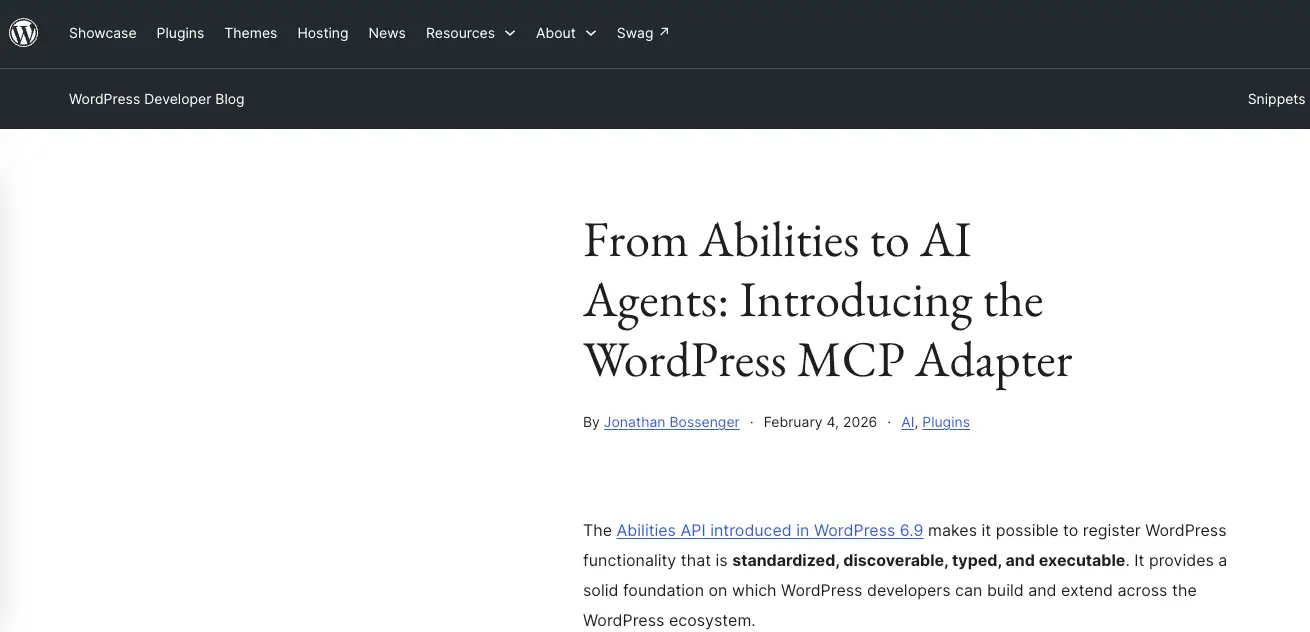
分享几个我平时工作过程中用得比较多的 MCP 工具,涉及数据调研、内容抓取、网站更新,以及后续的数据分析。 数据调研这块,之前用过一段时间的 DataForSEO MCP,主要处理关键词研究,看搜索结
传统 SEO 主要是跟踪关键词排名,但在 AI 搜索的当下,我们的网站品牌在 AI 搜索回答里并没有稳定的“第几名”概念。 更多的是我们的品牌被 AI 模型提及了多少次,或者引用了多少次。 目前谷歌站
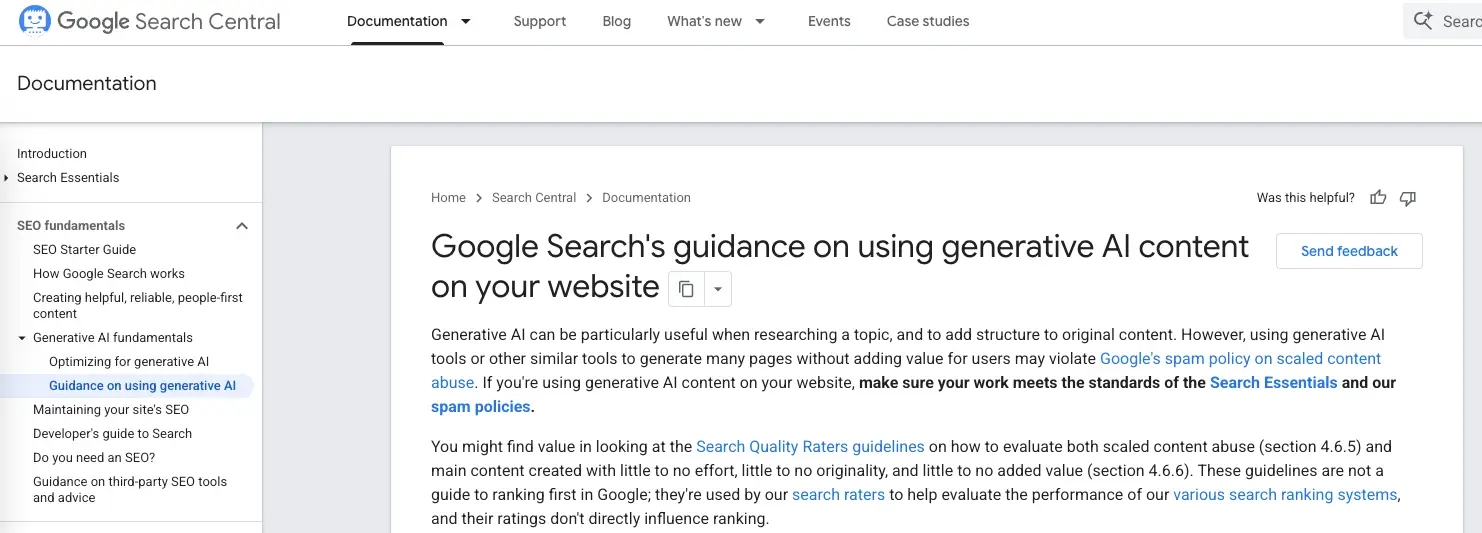
谷歌搜索中心官方博客在 1 号更新了关于网站使用生成式 AI 内容的官方指南,下午我自己看了一遍,觉得这可以展开聊聊这件事。 这篇官方指南所传达的信息很重要,第一次以非常强烈的措辞要求网站发布者在内容
找到用户在网上的痕迹,并通过这些痕迹去分析用户的需求,我觉得非常有必要。 如果我做的是 C 端独立站,一般我会去几个主流的电商平台上,调研用户在商品信息详情下的评价信息。 这种方法其实没有什么捷径可走
从八月份开始 Google Discover 信息流开始有了两个明显的变化,一是视频相关的内容越来越多,二是广告出现的次数也越来越多。 像下面这张图片便是我刚刚截取的信息流上的一部分内容,可以非常明显
现在 CodeX 这样的工具越来越方便了,如果你想做 On-Page SEO 相关细节审核,仅仅只需要一条命令便可以很顺利地将整个流程进行下去。 AI 会自动打开浏览器,然后打开具体的网页,读取里面的
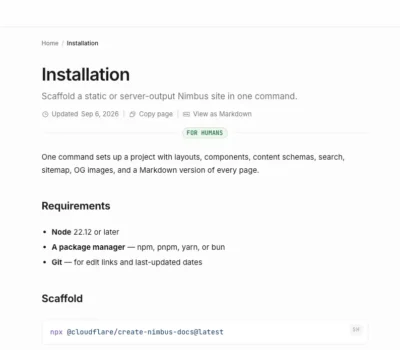
简单分享一下 Cloudflare 最近发布的这个叫做 Nimbus 的开源文档框架。 之所以想分享这个内容,主要原因有两点。 一是这个文档框架特别适合用来做内容类型站点,类似上图这样的布局,左侧大分
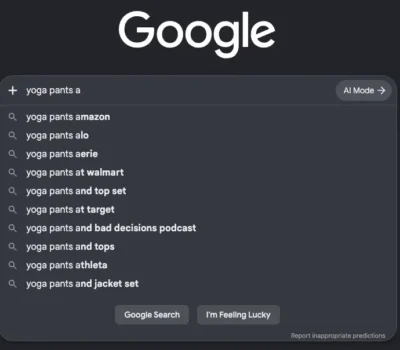
之前有篇文章分享了 Jev 这款模型在 SEO 领域内的一些应用场景,写完那篇文章之后便开始着手开发了一款关键词属性判断脚本。 应用场景非常简单,就是对一大堆关键词进行属性判断,并进行相应的主题聚类。
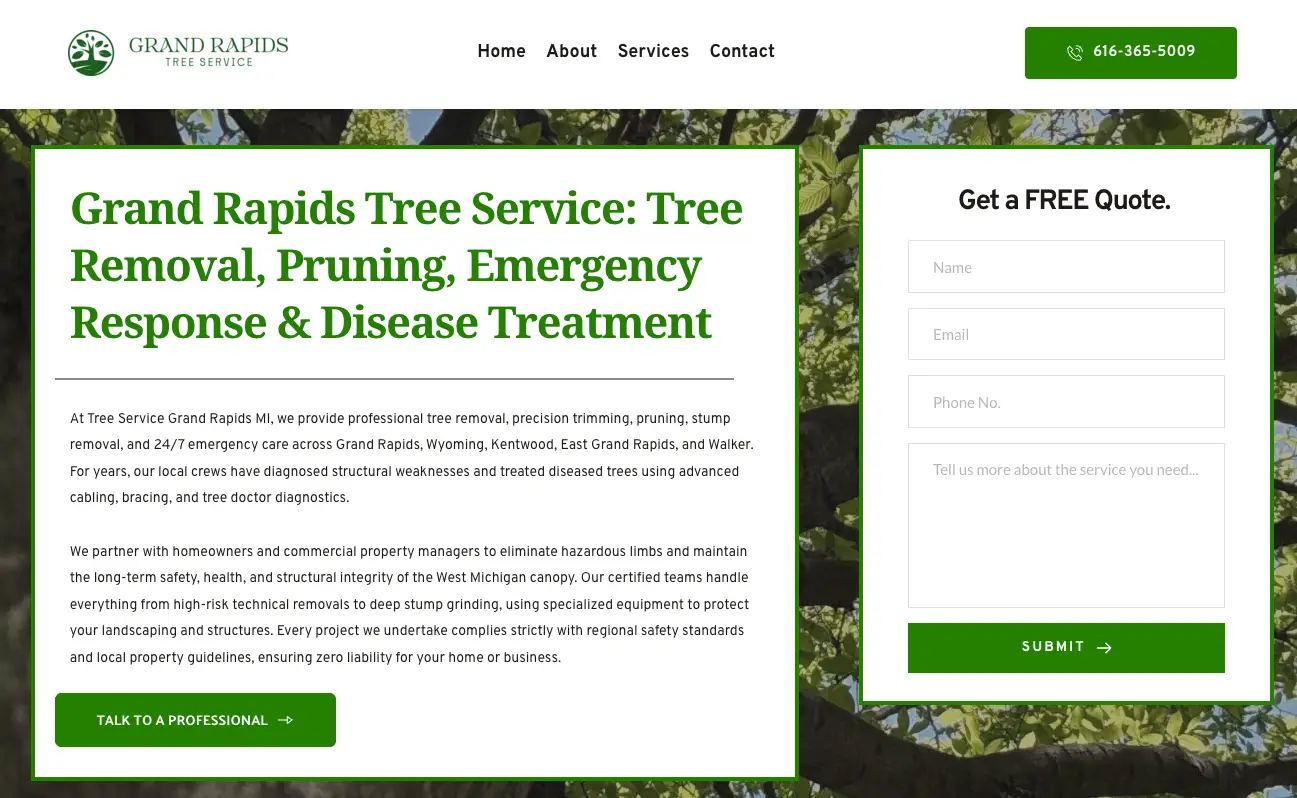
分享一个这两天看到的 Local SEO 案例。 逻辑比较简单:搭建一个本地服务类型的网站,并做好本地 SEO 相关的设置来获取精准的本地搜索流量。 至于这类本地流量的变现,如果你有后端交付能力的话可
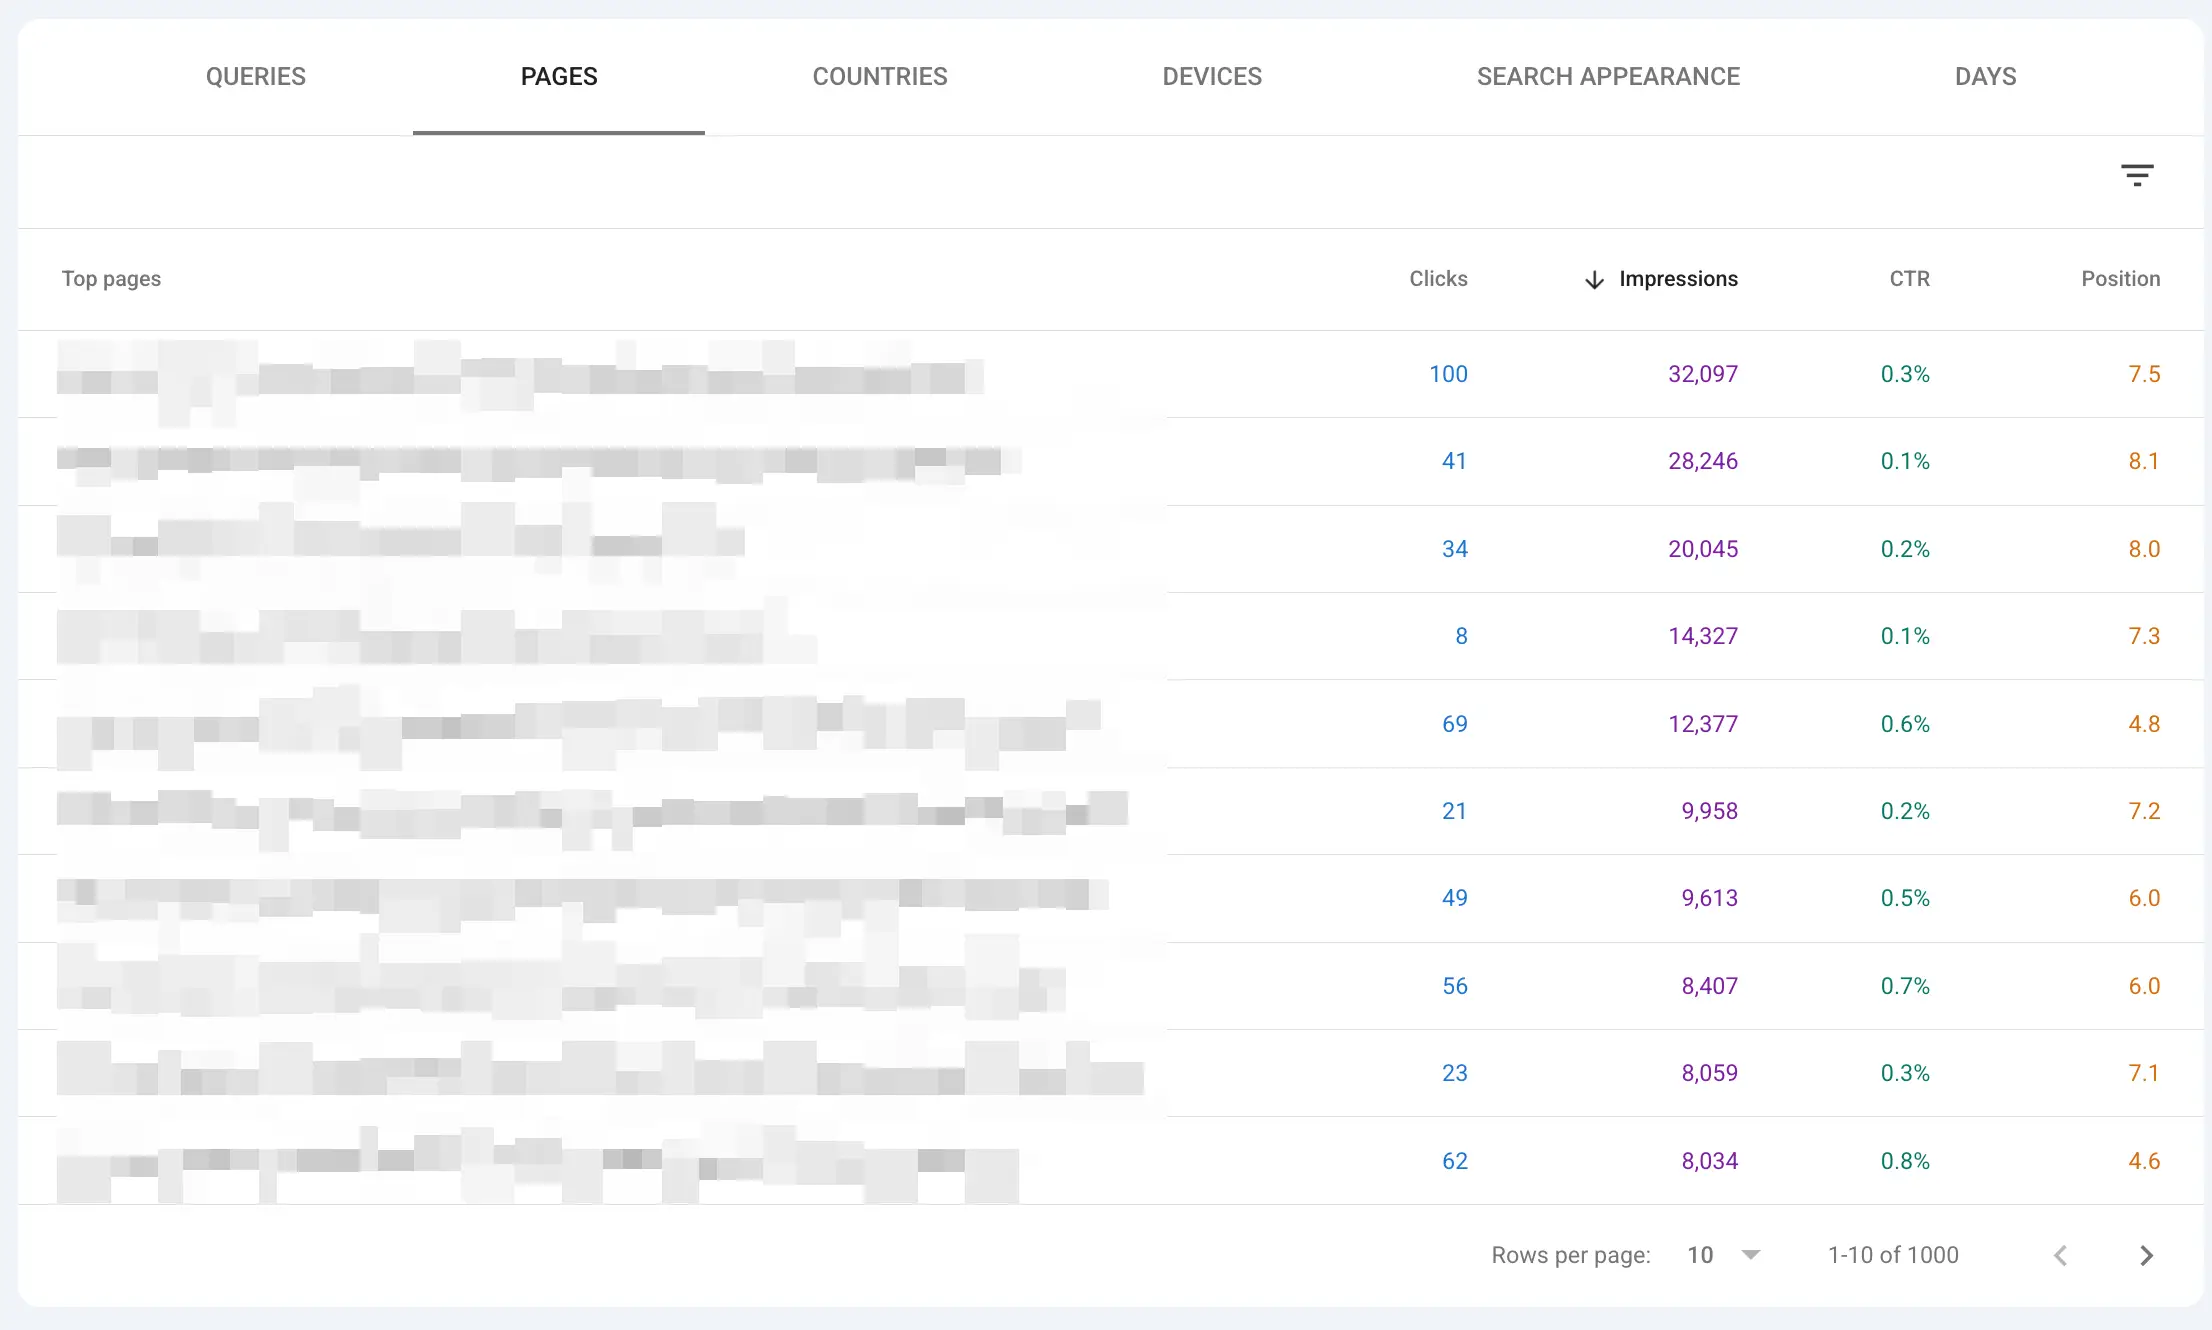
相较于优化网站上的已有内容,我平时更喜欢写新内容,单纯就是因为优化已有内容非常消耗心力。 你先得通读一下这篇已有内容主要写的什么,再去做数据统计并做想好相应的 GAP 分析,然后还需要设计内容更新计划
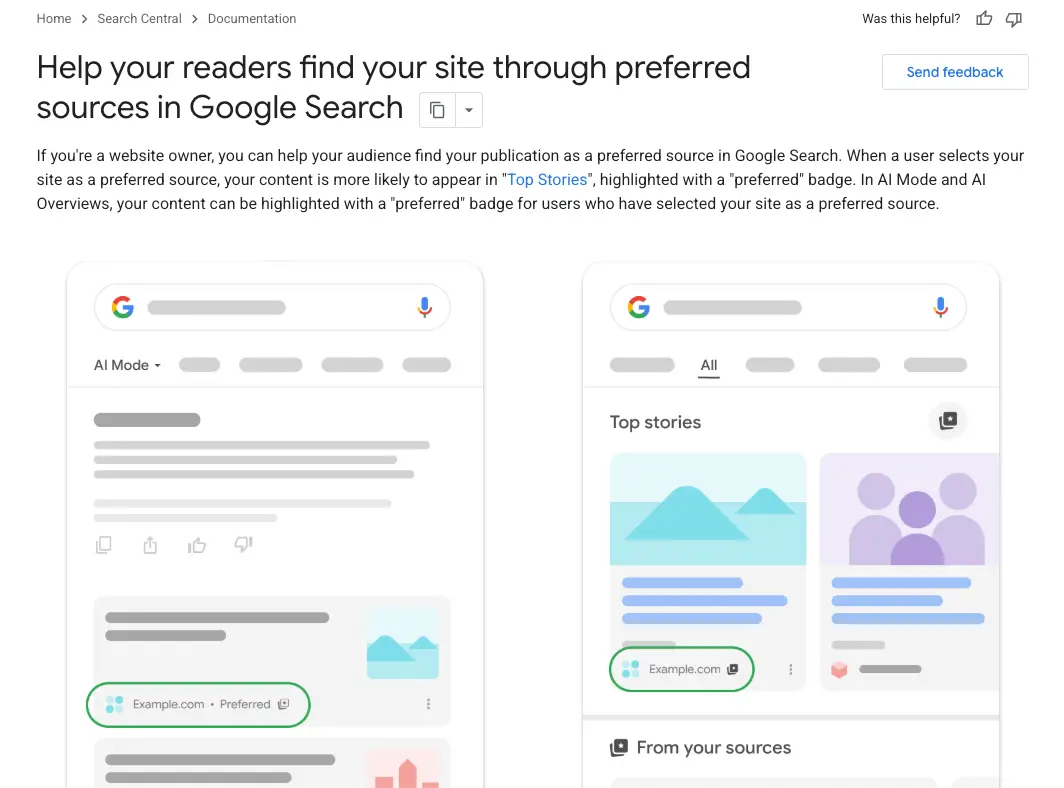
前两天谷歌更新了 Preferred Sources 文档,其中有一个比较重要的点,就是现在站长可以直接在网站、邮件和社媒中引导用户把自己的域名设为“首选来源”。 当你的网站被用户选中并标记后,那后续
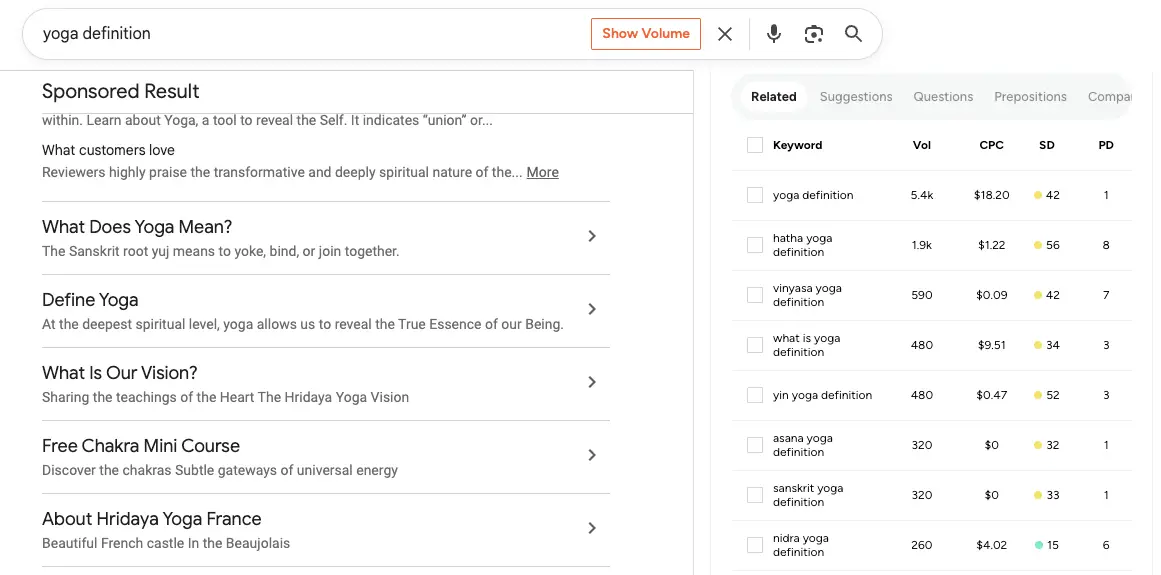
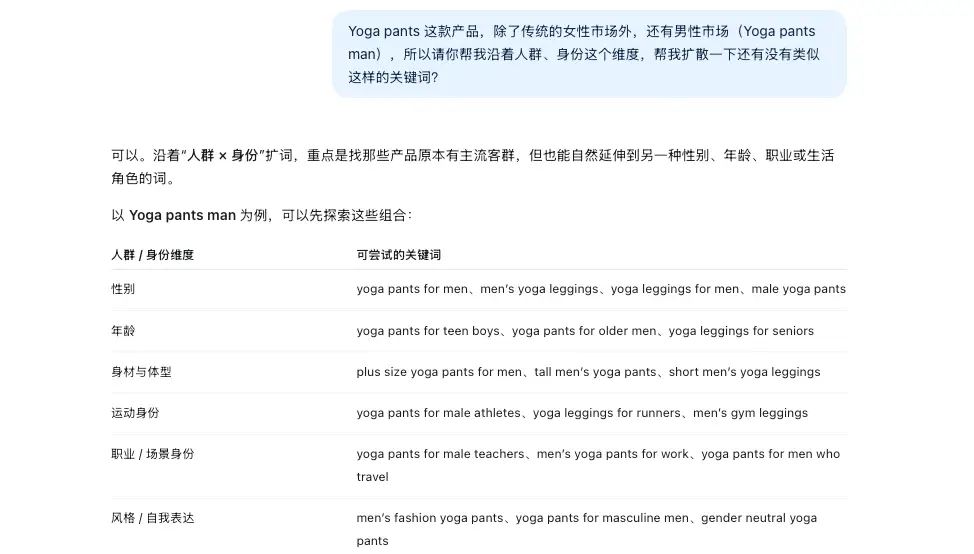
在关键词的调研上 AI 模型的能力已经很强了,即便这样,我还是喜欢在调研阶段更多靠自己动手挖掘信息。 等基础大方向确定之后,再来借助 AI 模型的能力进行数据放大。 比如最基础的一种模式,反查竞争对手
这两天社交媒体里全在刷屏 Jev 模型,趁着周末特意恶补了一下它的基础知识。 这款模型与传统生成式大模型最大的不同在于:Jev 完完全全不生成任何文本,它只专注于提供毫秒级、超低成本的结构化决策。 比
之前的文章分享中有谈过,我最近在实验着用 AI 做内部链接优化。 但目前市面上这些开源的 skill 都存在着一些比较大的弊端。 比如最简单的一个场景,你下载一个 skill 并让这个 skill 扫
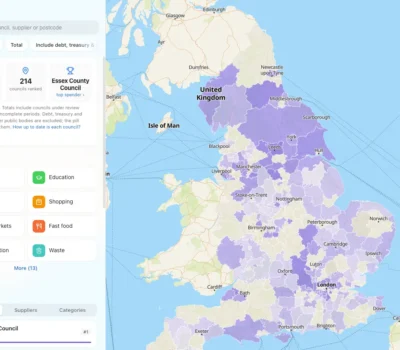
过去做程序化 SEO 站点时,一般的逻辑都是去找数据,然后对数据进行清洗并分组整理。 等数据梳理得差不多之后,便可以基于数据逻辑和业务逻辑将其在页面上展示出来。 有些时候数据集会非常庞大,自然会导致最
今天体验了一下 Agent-Reach 这个项目,整体表现挺不错的。 其实它解决的是一个看似比较简单、但实际处理起来比较棘手的问题:如何让 AI Agent 真正具备稳定且实用的线上信息获取能力。 我
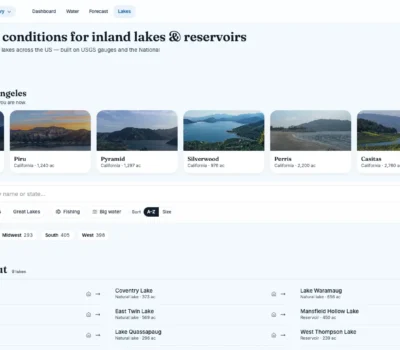
今天在外面有事,简单分享一个最近看到的水文类目录站点。 这个站点的组织结构比较简单,按照地理位置进行划分,将该区域内的河流、湖泊等等水文信息都组织了起来。 整个站点做出来其实不难,看这种 UI 风格大